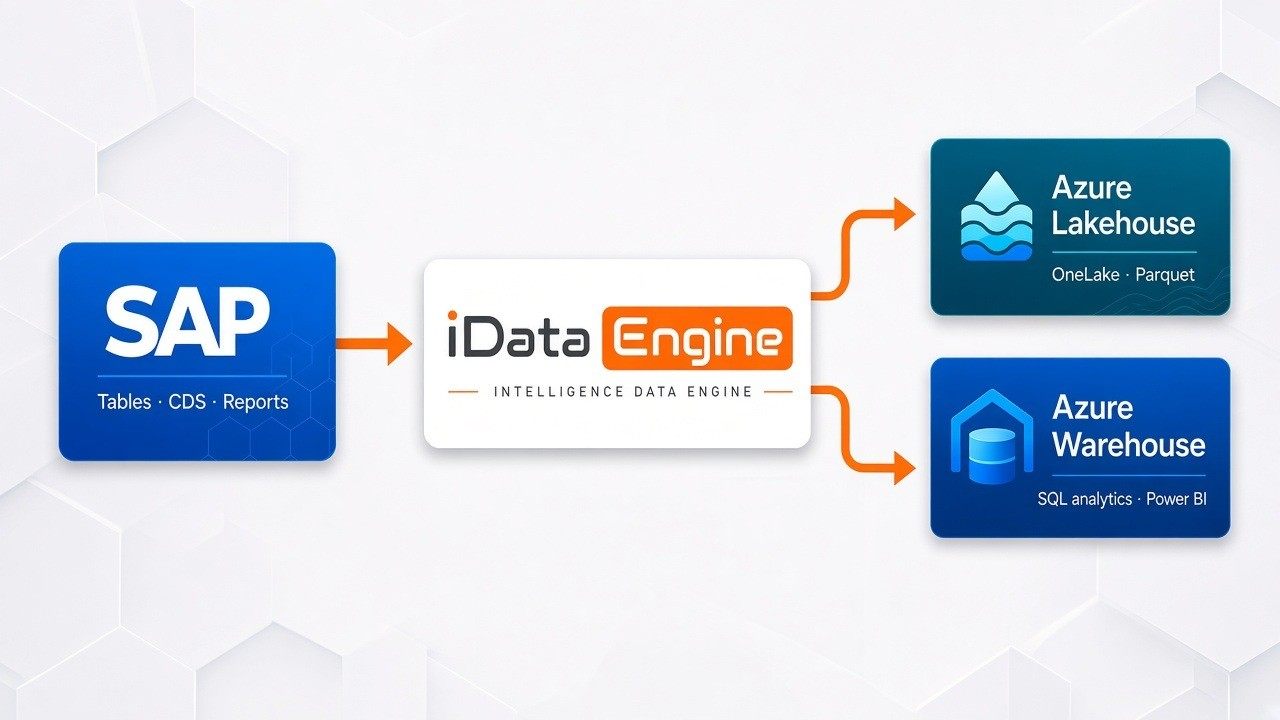
SAP kullanan kurumlarda Power BI, Fabric, veri bilimi ve yapay zekâ projelerinin sayısı arttıkça SAP verisinin Azure tarafında kullanılmasına yönelik ihtiyaç da büyüyor.
Ancak SAP verisini Fabric’e taşımak yalnızca bir veri aktarım problemi değildir. Asıl konu; farklı veri aktarım yöntemleriyle oluşturulan süreçlerin zaman içinde nasıl yönetileceği, ölçekleneceği ve sürdürüleceğidir.
Bugün SAP verisini Azure’a taşımak için farklı yaklaşımlar kullanılabiliyor:
- SAP connector’ları ile proje bazlı veri aktarım süreçleri
- ETL/ELT araçlarıyla oluşturulan pipeline’lar
- Replication çözümleri
- SAP tarafında geliştirilen özel veri çıkışları
Bu yöntemlerin her biri belirli senaryolarda çalışabilir. Ancak veri ihtiyaçları arttıkça aynı sorunlar ortaya çıkmaya başlar:
- Yeni bir ihtiyaç → yeni aktarım tanımı
- Yeni bir SAP kaynağı → yeni geliştirme veya yeni pipeline
- Yeni bir hedef → yeni eşleme ve dönüşüm
- Artan veri hacmi → yeniden performans çalışması
- Değişen iş ihtiyacı → mevcut aktarım süreçlerinde değişiklik
- Teknik zorluklar ve öğrenme eğrisi
Bir süre sonra SAP verisinin Azure’a taşınması, tek bir veri altyapısı yerine birbirinden bağımsız çok sayıda entegrasyon sürecinin yönetilmesine dönüşür. Aynı SAP tablosu farklı projeler için farklı şekillerde aktarılabilir. Aynı veri birden fazla pipeline tarafından işlenebilir. Zamanlama, delta yönetimi, filtreleme, performans ve hata takibi her süreçte yeniden ele alınabilir.
Sonuçta problem SAP verisini Azure’a taşımak değil; SAP verisinin Azure’daki kullanımını sürdürülebilir şekilde yönetmektir.
iDataEngine yaklaşımı
iDataEngine bu noktada farklı bir yaklaşım sunar: SAP kaynaklarını tek tek projelerin parçası olarak değil, merkezî olarak yönetilen veri kaynakları olarak ele alır.
SAP tabloları, standart ve Z’li raporlar ile CDS View’lar iDataEngine üzerinde tanımlanır. Aktarılacak alanlar, filtreler ve seçim kriterleri merkezî olarak belirlenir. Bu kaynaklar daha sonra farklı ihtiyaçlarda tekrar kullanılabilir.
Hedef tarafında kullanım senaryosuna göre: SQL tabanlı analitik ve Power BI için Microsoft Fabric Warehouse; veri mühendisliği, ileri analitik ve yapay zekâ için Microsoft Fabric Lakehouse / OneLake. Lakehouse senaryosunda veri, analitik iş yüklerine uygun Parquet formatında yazılabilir.
Aktarımın kendisi de merkezî olarak yönetilir: zamanlama, full/delta aktarım, veri kapsamı, çalışma geçmişi, hata takibi ve aktarım durumu tek bir yapı üzerinden yönetilir.
Fark nerede?
Geleneksel yaklaşımda her yeni proje kendi veri aktarım ihtiyacını oluşturabilir. iDataEngine yaklaşımında ise SAP veri kaynağı bir kez tanımlanır ve farklı projelerin kullanımına açılır.
Böylece SAP → iDataEngine → Fabric akışı, her proje için yeniden tasarlanan bir entegrasyon yerine kurumun ortak SAP veri aktarım katmanı hâline gelir. Yeni bir Power BI raporu veya yapay zekâ projesi başladığında SAP tarafında yeni bir veri çıkarma süreci oluşturmak yerine, mevcut veri kaynakları ve aktarım altyapısı üzerinden ilerlenebilir.
Daha az tekrar. Daha az entegrasyon karmaşası. Daha merkezî yönetim. Daha sürdürülebilir bir SAP–Fabric veri altyapısı.
Kendi SAP verinizle deneyin
Teorik bir demo yerine kendi veriniz üzerinde değerlendirelim. Kurumunuz için anlamlı bir SAP tablosu, raporu veya CDS View’ı seçin; bu kaynağın Fabric Warehouse veya Lakehouse’a nasıl aktarıldığını kendi ortamınızda ve kendi veri hacminizle birlikte görelim.